システム刷新という話 第5話
“たどる”から“次の行動を考える”へのドキュメント管理の話 2/2 (Agentic RAG化)
minmaのエンジニアリングマネージャーのユジンです。
前回は、
長年蓄積された障害履歴や設計資料をRAGへ取り込み、
意味の近い情報を検索し、
さらにGraph DBによって情報同士の関係をたどる仕組みについて紹介しました。
今回は、
そのRAGを土台に、
集めた情報が判断に十分かを評価し、
不足している情報を追加で探しながら、
次のTodoを考えるAgentic RAGへ発展させた話です。
ただし、
Agenticな仕組みにすること自体が目的ではありません。
私たちが確認したいのは、
こうした技術によって、
実際の業務をどの程度、
どのように改善できるのかという点です。
1. 良い答えは、良い質問から生まれる
仕事柄、
エンジニア採用の面接をする機会があります。
例えば、
候補者から 障害対応を経験しました という回答があったとします。
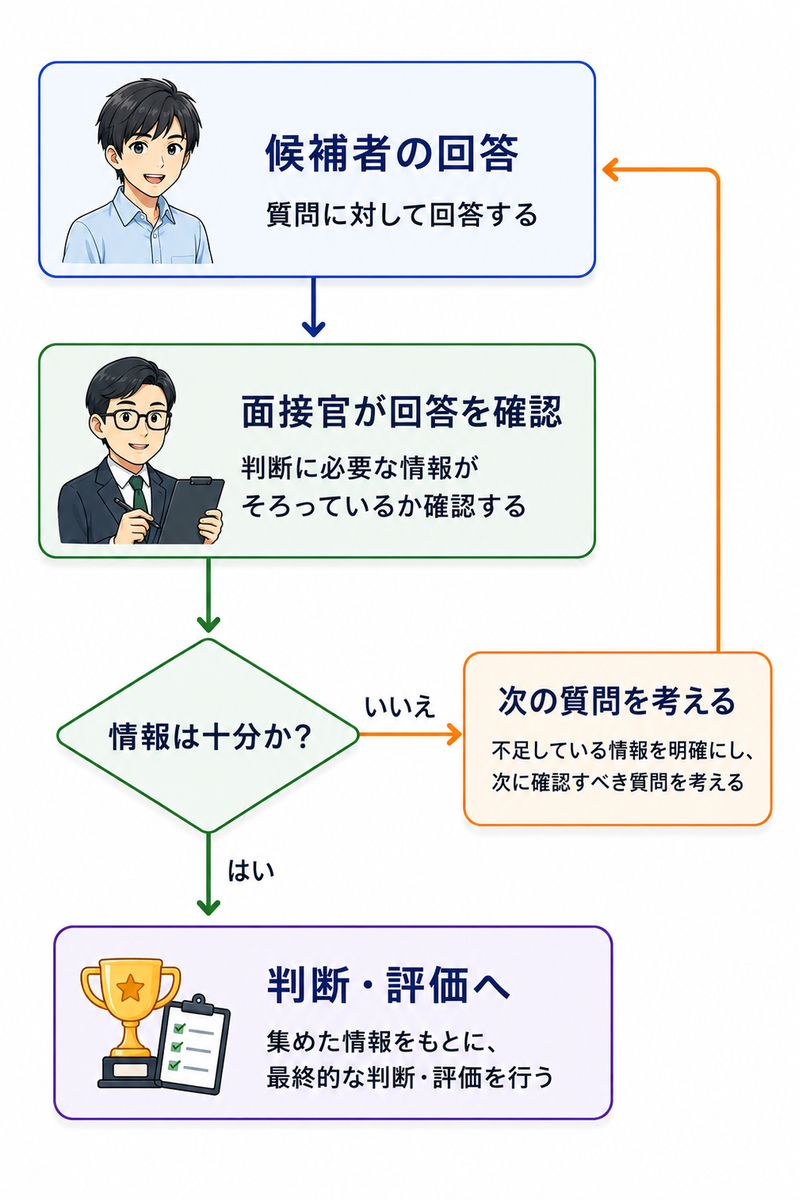
面接官は、
そこで終わらず、回答に応じて質問を続けます。
どのような障害でしたか?
回答を聞いた後、さらに質問します。
原因をどのように特定しましたか?
再発防止のために、どのような対応をしましたか?
面接官は、
最初から決められた質問を読み上げるだけではありません。
回答から不足している情報を見つけ、
次に何を確認すべきかを考えながら、
判断に必要な情報をそろえていきます。
ただし、面接官が探しているのは、
あらかじめ決められた一つの正解ではありません。
採用するポジションやスキルのレベルに応じた評価基準と照らし合わせながら、
判断に必要な情報がそろっているかを確認しています。
今回作ったAgentic RAGも、
得られた情報が十分かを評価し、
不足していれば追加の質問や検索を行うという、
これに近い動きをします。
2. RAGからAgentらしい処理への段階的な進化
面接に置き換えると、
RAG型のアプリは、履歴書や過去の面接記録から、
質問に関係する情報を探す役割です。
例えば、次の質問に答えます。
この候補者には、障害対応の経験がありますか?
RAG型のアプリは、
履歴書や面接記録から該当する情報を探し、
前職で、API障害の調査と復旧対応を経験しています
と回答します。
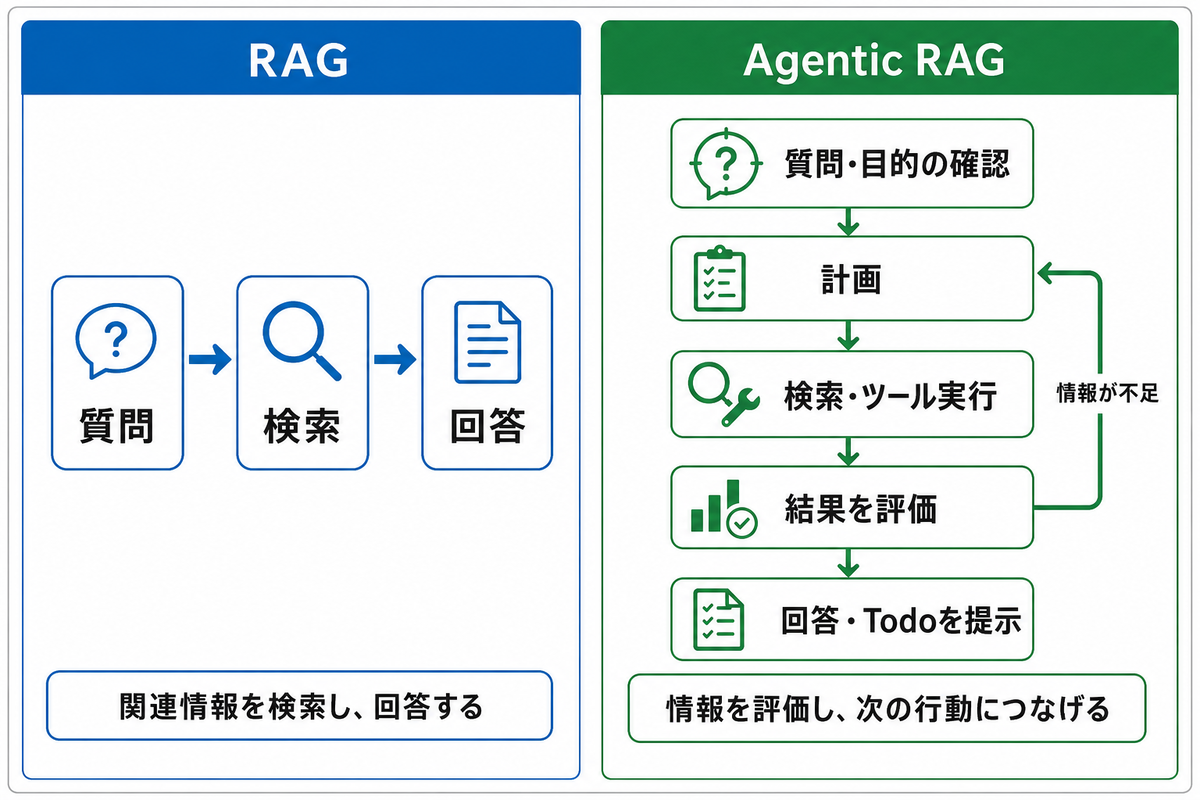
一方、
Agentic RAGは、情報を一度探して回答するだけでは終わりません。
障害対応の経験は確認できました。
ただし、本人がどこまで原因調査を担当したのか、
また、再発防止まで関わったのかは分かりません。
次に、その2点を確認する必要があります
というように、
得られた情報が、判断に十分かを評価します。
情報が足りなければ、
次に確認すべきことを考え、
必要な情報をもう一度検索します。
そして、集めた情報を整理し、
次に確認すべきことやTodoを提示します。
面接官が、
候補者の回答を聞きながら次の質問を変えるように、
Agentic RAGも、
検索結果に応じて次の検索や処理を変えていきます。
| 項目 | RAG | Agentic RAG |
|---|---|---|
| 役割 | 関連情報を検索し、回答する | 情報を評価し、次の行動につなげる |
| 処理 | 検索 → 回答 | 計画 → 検索 → 評価 → 必要に応じて再検索 |
| 情報不足時 | 次の調査は人が考える | 追加検索や確認事項を提示する |
| 判断基準 | 質問との関連性 | 目的・ADR・過去事例 |
| 得られるもの | 関連情報と回答 | 判断材料・根拠・Todo |
3. Agentic RAGの判断材料としてADRを使う
面接官は、
候補者の回答を聞いて、
思いつきだけで次の質問を決めているわけではありません。
募集するポジションに求める役割や、
技術力、問題解決力、チームとの関わり方など、
判断の土台となる評価基準があります。
候補者の回答を評価基準と照らし合わせ、
判断に必要な情報が足りなければ、
次に何を確認するべきかを考えます。
Agentic RAGにも、
これと同じような判断の土台が必要です。
現行システムで守るべき方針や、
システム刷新における意思決定、
その判断理由や制約を参照することで、
現在の状況が設計方針に沿っているか、
判断に必要な情報が不足していないかを確認できます。
そこで、Agentic RAGの判断材料として活用したのが、
ADR(Architecture Decision Record)です。
minmaのADRとは、
システム刷新の設計における重要な意思決定と、
その背景や理由を記録するものになっています。
4. システム刷新の判断を、ADRとして残していく
面接では、
候補者への質問や評価基準を、
一度決めたら終わりにするわけではありません。
実際の面接で得られた気づきをもとに、
質問や評価の観点を見直し、
次の面接へ生かしていきます。
システム刷新も同じです。
minmaでは現在、
システム刷新を進めるなかで、
設計上の重要な判断と、
その理由をADRとして残していく取り組みを進めています。
どのような選択肢を検討したのか。
なぜ、その構成や技術を選んだのか。
どのような制約や影響があるのか。
こうした背景まで記録することで、
後から参加したメンバーも、
現在の設計に至った理由を確認できます。
ただし、
ADRは記録するだけでは、
十分に活用されません。
システム刷新が進み、
ADRが増えていくほど、
現在の変更に関係するADRを見つけ、
その内容を状況と照らし合わせることが難しくなります。
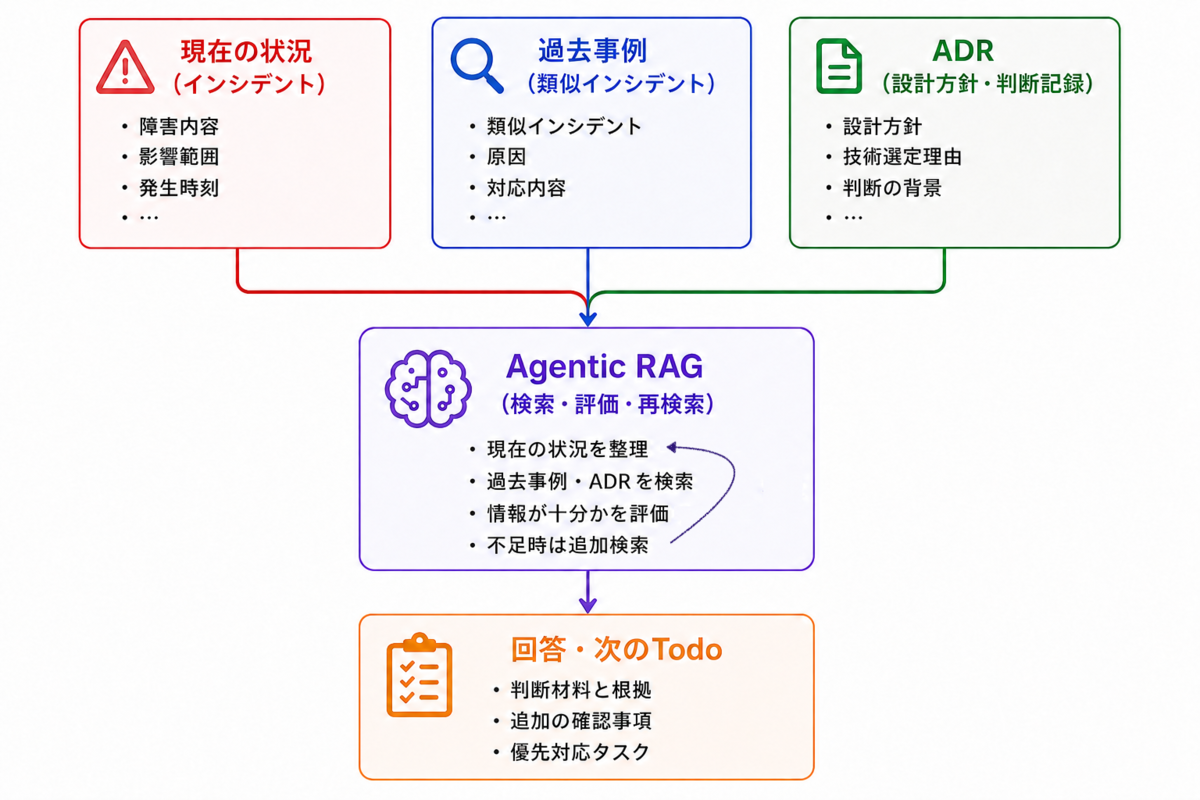
今回のAgentic RAGでは、
現在の状況、
関連するADR、
過去の事例を組み合わせ、
設計方針との違いや不足している情報を整理します。
そして、
次に確認すべきことを Todo として提示できる仕組みを目指しました。
5. 技術的に動くだけでは、業務改善にはつながらない
Embedding、Vector DB、Graph DBに、
Agentic RAGの反復処理を組み合わせることで、
関連情報を探し、状況を整理し、
次に確認すべきことを提示できるようになります。
しかし、
仕組みが動いたことだけでは、
業務を改善できたとは言えません。
私たちが本当に解決したいのは、
例えば次のような、実際の業務課題です。
特定の時間帯にAPIの応答が遅くなり、一部のリクエストでタイムアウトが発生している。
RAG型のアプリは、
過去の類似インシデントや、
関連する設計資料を探します。
過去にも、バッチ処理の実行時間帯に、データベースの応答が遅くなった事例があります。
これは調査の手がかりになりますが、
今回も同じ原因だと判断することはできません。
そこでAgentic RAGは、
現在分かっている情報をもとに、
次に確認すべきことを整理します。
- タイムアウトが発生しているAPIと影響範囲を確認する
- 対象時間帯のアクセス数を確認する
- データベースの負荷とスロークエリを確認する
- 同じ時間帯に実行されたバッチを確認する
- 外部APIなど、ほかの依存先の応答時間を確認する
- 直近の変更履歴と関連するADRを確認する
そして、確認結果に応じて、
次に調べる内容を変えていきます。
例えば、
バッチの実行時間とAPIの遅延時間が一致し、
同じ時間帯にデータベースの負荷も上昇していた場合、
Agentは過去の類似事例や関連するADRを参照し、
次のように整理します。
現在の状況:
・バッチの実行時間とAPIの遅延時間が一致している
・同じ時間帯にデータベースの負荷が上昇している
・外部APIの応答時間には大きな変化がない

関連情報:
・過去にも、バッチ実行時のDB負荷上昇とAPI遅延が重なった類似事例がある
・処理の責務や実行基盤に関するADRがある

次のTodo:
1. 対象バッチの処理内容と接続先を確認する
2. バッチの停止や実行時間の変更による業務影響を確認する
3. 検証環境での再現、または実行時間の一時的な変更により、負荷が改善するか確認する
4. 恒久対応として、処理やリソースの分離を検討する

追加で確認が必要なこと:
・現在の構成を採用した理由
・関連するADRが現在も有効か
・変更による他サービスへの影響
このように、
過去の事例を見つけて終わるのではなく、
現在の状況との共通点や違いを確認し、
考えられる仮説と、次に調べるべきことを提示します。
ここで重要なのは、
Agentic RAG型のアプリが、
勝手に本番環境を変更するわけではないことです。
Agentが行うのは、
現在の状況、判断材料、対応の選択肢、
それぞれのリスクを整理するところまでです。
サービスに影響する操作や最終判断は、
minmaのエンジニアが確認したうえで行います。
6. Agentic RAGの品質を、どう高めるか
面接では、
経験のある面接官でも、
最初から必ず良い質問ができるとは限りません。
面接後には、
判断に必要な情報を確認できたか、
質問が誘導的になっていなかったか、
評価基準に沿って判断できたかを振り返ります。
その結果をもとに、
質問や面接の進め方を改善していきます。
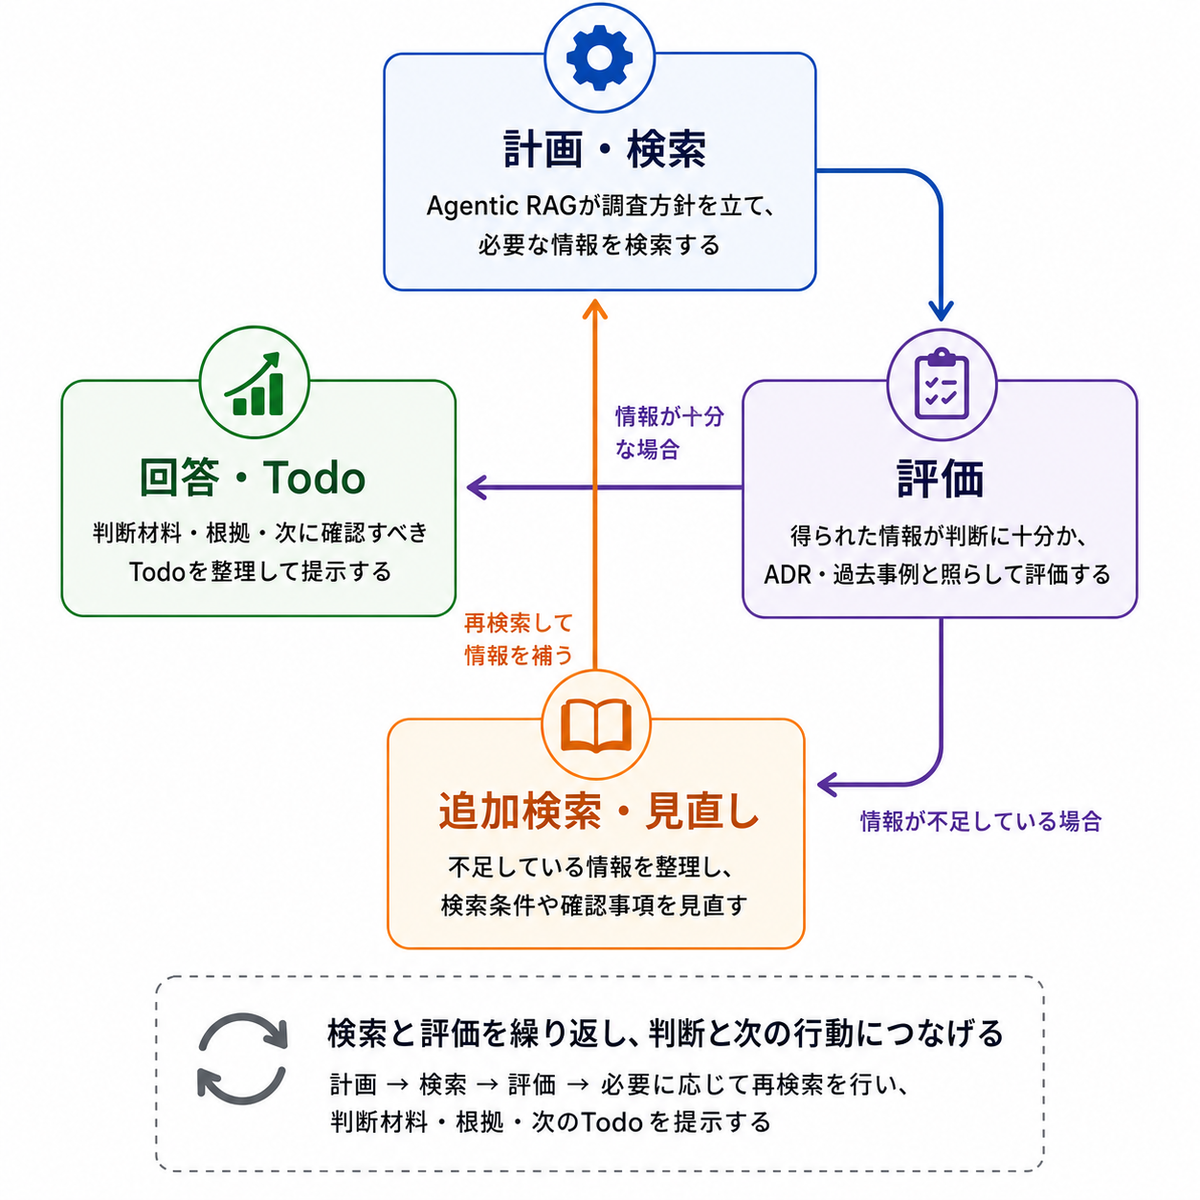
Agentic RAGの品質を高める過程も、
これに似ています。
Agentic RAGは、
検索ツールを接続しただけで、
安定して良い提案ができるわけではありません。
安定した結果を得るためには、
目的や利用できる情報、判断手順に加えて、
人へ確認する条件や、
十分な情報がそろったと判断する条件を
設計する必要があります。
今回の障害調査では、
例えば次のような流れを基本にしながら、
得られた情報に応じて確認内容を変えていきます。
- 症状と影響範囲を整理する
- 直近の変更履歴を確認する
- メトリクスとログを確認する
- Vector DBから類似インシデントを検索する
- Graph DBから関連システムとADRをたどる
- 過去の事例と現在の状況との差を確認する
- 不足情報と次のTodoを整理する
- 人が判断できる形で結果を提示する
7. 「探す」から「次の行動を考える」へ
これまでの流れを整理すると、
次のようになります。
Embeddingによって、
文章の意味を数値として表現する。
Vector DBによって、
意味の近い情報を探せるようにする。
Graph DBによって、
情報同士の関係をたどれるようにする。
ADRによって、
システム刷新における意思決定と、その根拠を残す。
そしてAgentic RAGによって、
得られた情報が十分かを評価し、
不足していれば追加で情報を探します。
必要な情報がそろったら、
現在の状況や過去の事例、
関連するADRを組み合わせ、
次に確認すべきことを提示します。
記録する → 探す → たどる
そして、たどる から 次に何をするかを考えるへ。
今回のAgentic RAG化は、
RAGに新しい機能を追加して終わることが
目的ではありません。
これまで蓄積してきた知識を、
必要なときに探せるだけでなく、
実際の判断や次の行動につなげられる形へ変えるための取り組みです。
最後に
今回私たちが作ったのは、
エンジニアの仕事をすべてAIに任せるものではありません。
必要な情報を検索して整理し、
情報が不足していれば追加で確認し、
判断材料や次の行動を提示する。
人とAIが協業しながら、
より良い判断につなげるための
Agentic RAG型のアプリです。
Agentic RAGでは、
LLMの性能だけでなく、
判断の土台となるデータの品質も重要です。
インシデント情報やADRに誤りや不足があれば、
適切な検索や提案にはつながりません。
また、
Embeddingの精度や設計、
Vector DBの検索精度、
Graph DBの構造、
Agentの判断手順によっても、
得られる結果は変わります。
そのため、
データを整備し、検索結果や提案を評価しながら、
仕組みを継続的に改善していく必要があります。
minmaでは、
こうした仕組みを一緒に考え、
システム刷新を進めてくれるエンジニアを募集しています。
技術を導入するだけでなく、
実際の業務でどのように役立てるかまで考えたい方と、
一緒に取り組んでいけたらうれしいです。
Appendix
本文では、Agentic RAGの考え方と設計思想を中心に紹介しました。
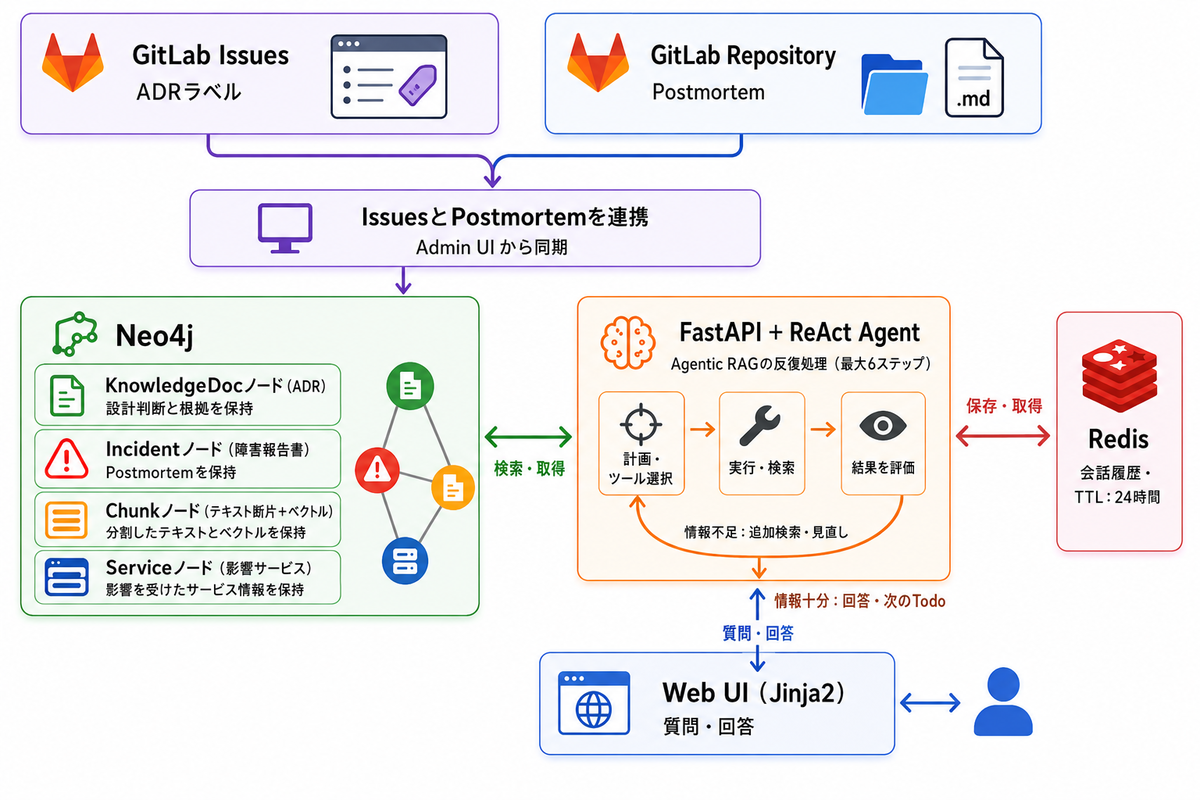
Appendixでは、今回のアプリで使用した技術と実装構成を、エンジニア向けにまとめます。
A. 全体のデータフロー
B. 技術スタック
| レイヤー | 技術 | 役割 |
|---|---|---|
| LLM | Amazon Bedrock(Claude Sonnet 4.5) | 回答生成・調査計画の立案・検索結果の評価 |
| Embedding | Amazon Titan Text Embeddings V2(1,024次元) | テキストのベクトル変換 |
| Vector/Graph DB | Neo4j | ベクトル検索・関係グラフの探索 |
| Session | Redis | 会話履歴・会話状態・共有スナップショットの管理 |
| Web | FastAPI+Jinja2 | APIの提供・Web UIの生成 |
| LLM抽象化 | LangChain | LLM呼び出し・ツール実行・Agent処理の共通化 |
| 認証 | Cloudflare Access | ユーザー認証・管理者判定 |
| ADR管理 | GitLab Issues(ADR) | 設計上の意思決定と、その背景・根拠を記録 |
| 障害報告書管理 | GitLab Issues(Postmortem) | インシデントの経緯・原因・対応・再発防止策を管理 |
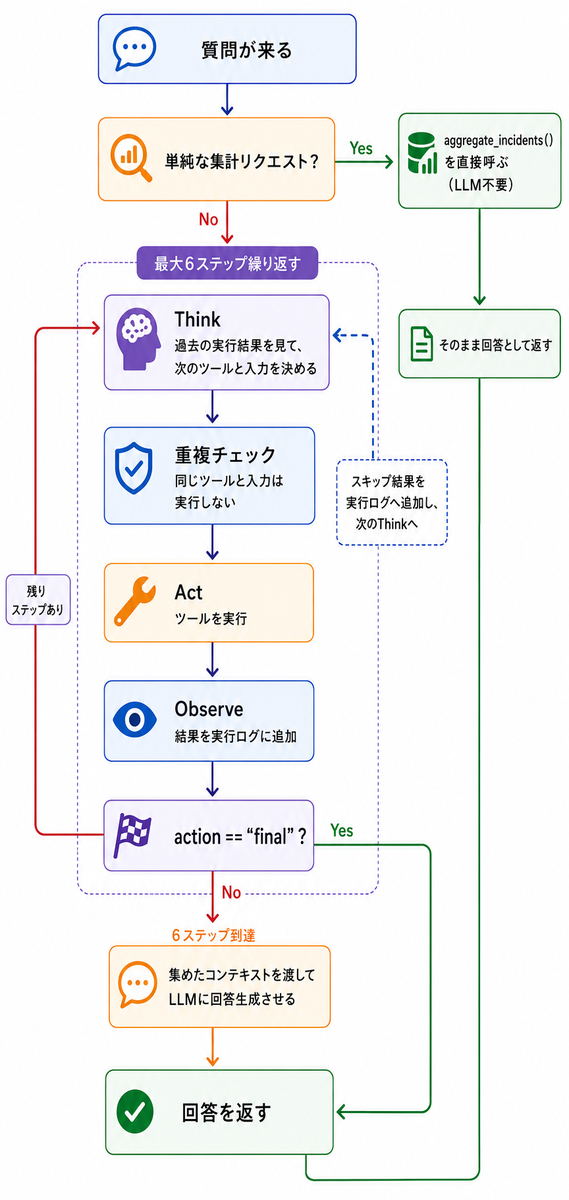
C. ReAct Agentが持つ5つのツール
ReActは、推論(Think)、行動(Act)、観察(Observe)を繰り返しながら、
必要な情報を集め、回答につなげるフレームワークです。
| ツール | 検索方式 | 何を探すか |
|---|---|---|
search_incidents |
ベクトル検索 | 過去の障害報告書(Postmortem) |
search_adr |
ベクトル検索 | GitLab ADR(設計方針・意思決定の記録) |
search_cp_rules |
全件取得 | 障害レベルの判定基準(Level 1〜4) |
search_services |
キーワード検索 | サービス情報・関連インシデント |
aggregate_incidents |
集計 | 年別・障害レベル別のインシデント件数 |
LLMには、質問、直近の会話、これまでのツール実行結果を渡します。
過去の実行結果を踏まえて次の処理を選べる点が、
単純なRAGとの大きな違いです。
D. 実装上の工夫
temperature=0.0
出力のランダム性を抑え、
ツール選択や回答のばらつきを小さくしています。
同じ条件で、できるだけ再現性の高い動作を得ることが目的です。
| temperature | tool選択 | 何を探すか | リスク |
|---|---|---|---|
| 0.0 | 選択が安定しやすい | 再現性を高めやすい | 必ず同じ結果になるとは限らない |
| 0.3〜0.7 | 選択に幅が出る | 複数の調査方針を試しやすい | ツール選択が変化しやすい |
| 1.0以上 | ばらつきが大きい | 多様な出力になりやすい | 業務用途では制御しにくい |
集計系の高速パス
「件数を教えて」のような質問はLLMにツール選択させず直接集計します。
不要なLLM呼び出しを省き、応答速度を改善しています。
Postmortem・ADRをGitLab Issuesで管理
ADRをMarkdownファイルではなくGitLab Issuesで管理することで、
更新日時の追跡・差分検知・Admin UIからのワンクリック同期を実現しています。
ドキュメントやラベルがついたIssueだけを対象とし、
GitLabで更新されると次回同期時にNeo4jへ反映されます。
Redisによる会話の一貫性管理
LLMに会話の文脈を持たせるため、ユーザーのメールをキーに履歴をRedisへJSON保存。
直近20件とsystemプロンプトだけ保持。